


사장님 입점신청 자동승인 주기를 10분에서 10초로
사장님의 입점신청 요청들은 자동승인 처리가 시작되기까지 최소 3분에서 최대 12분 59초가 걸렸습니다. 이 대기를 10초 이내로 줄인 과정을 기록한 글입니다.
그림 출처: AI 자동생성(https://youmind.com)
세 줄 요약
- 큐 역할을 하는 DB에 후보를 모았다가 처리하던 2단계 스케줄러(10분 주기)를 걷어내고, 요청 테이블과 처리 상태 테이블을 한 번에 보는 조회와 10초 폴링으로 변경했습니다. 자동승인 대상건 생성 후 처리 시작까지 최대 12분 59초 → 10초 이내로 개선했습니다(유입량이 처리 가능량을 넘지 않는다고 가정).
- 워커(자동승인 스케줄러가 도는 서버) N대 전부가 각각 폴링하고, 동시성은 락 안에서 상태를 확인하고 기록하는 구간이 막습니다. 처리 중간에 멈춘 건은 별도 클렌징 스케줄러가 되살립니다.
- 10초 폴링으로 주기를 기존의 1/60로 줄이면서도 외부 시스템으로 가는 부하는 변하지 않았습니다.
승인? 자동승인?
가게 사장님이 배달의민족에 입점하려면 계약과 승인 절차를 거쳐야 합니다. 이 요청들을 접수해서 승인까지 관리하는 사내 시스템이 있고, 저희 팀이 그 시스템을 개발하고 운영합니다. 서류가 다 갖춰졌고, 정책상 반려 사유가 없고, 앞 단계가 모두 끝난 요청은 사람이 판단할 것이 없습니다. 이러한 업주계약, 광고계약 요청을 시스템이 대신 승인하는 것이 자동승인입니다.
그런데 자동승인이 빠르지 않았습니다. 요청이 생긴 뒤 처리가 시작되기까지 최소 3분에서 최대 12분 59초가 걸렸고, 그동안 그 건은 담당자 목록에 그냥 밀린 일로 남아 있었습니다. 담당자가 기다리지 않고 직접 처리하면, 자동승인의 지연이 그대로 사람의 일로 넘어갑니다.
자동승인 대상의 대다수가 생성 즉시 자동승인이 가능한 요청들입니다. 반면 만들어질 때는 조건을 다 채우지 못했다가 나중에 갖춰지는 요청은, 조건이 갖춰진 뒤에도 다음 재시도 시각까지 기다립니다.
이 글은 주기를 줄이기 위해 어떤 고민을 했는지에 대한 기록입니다.
기존 구조에서 최소 대기 구간이 존재했던 이유
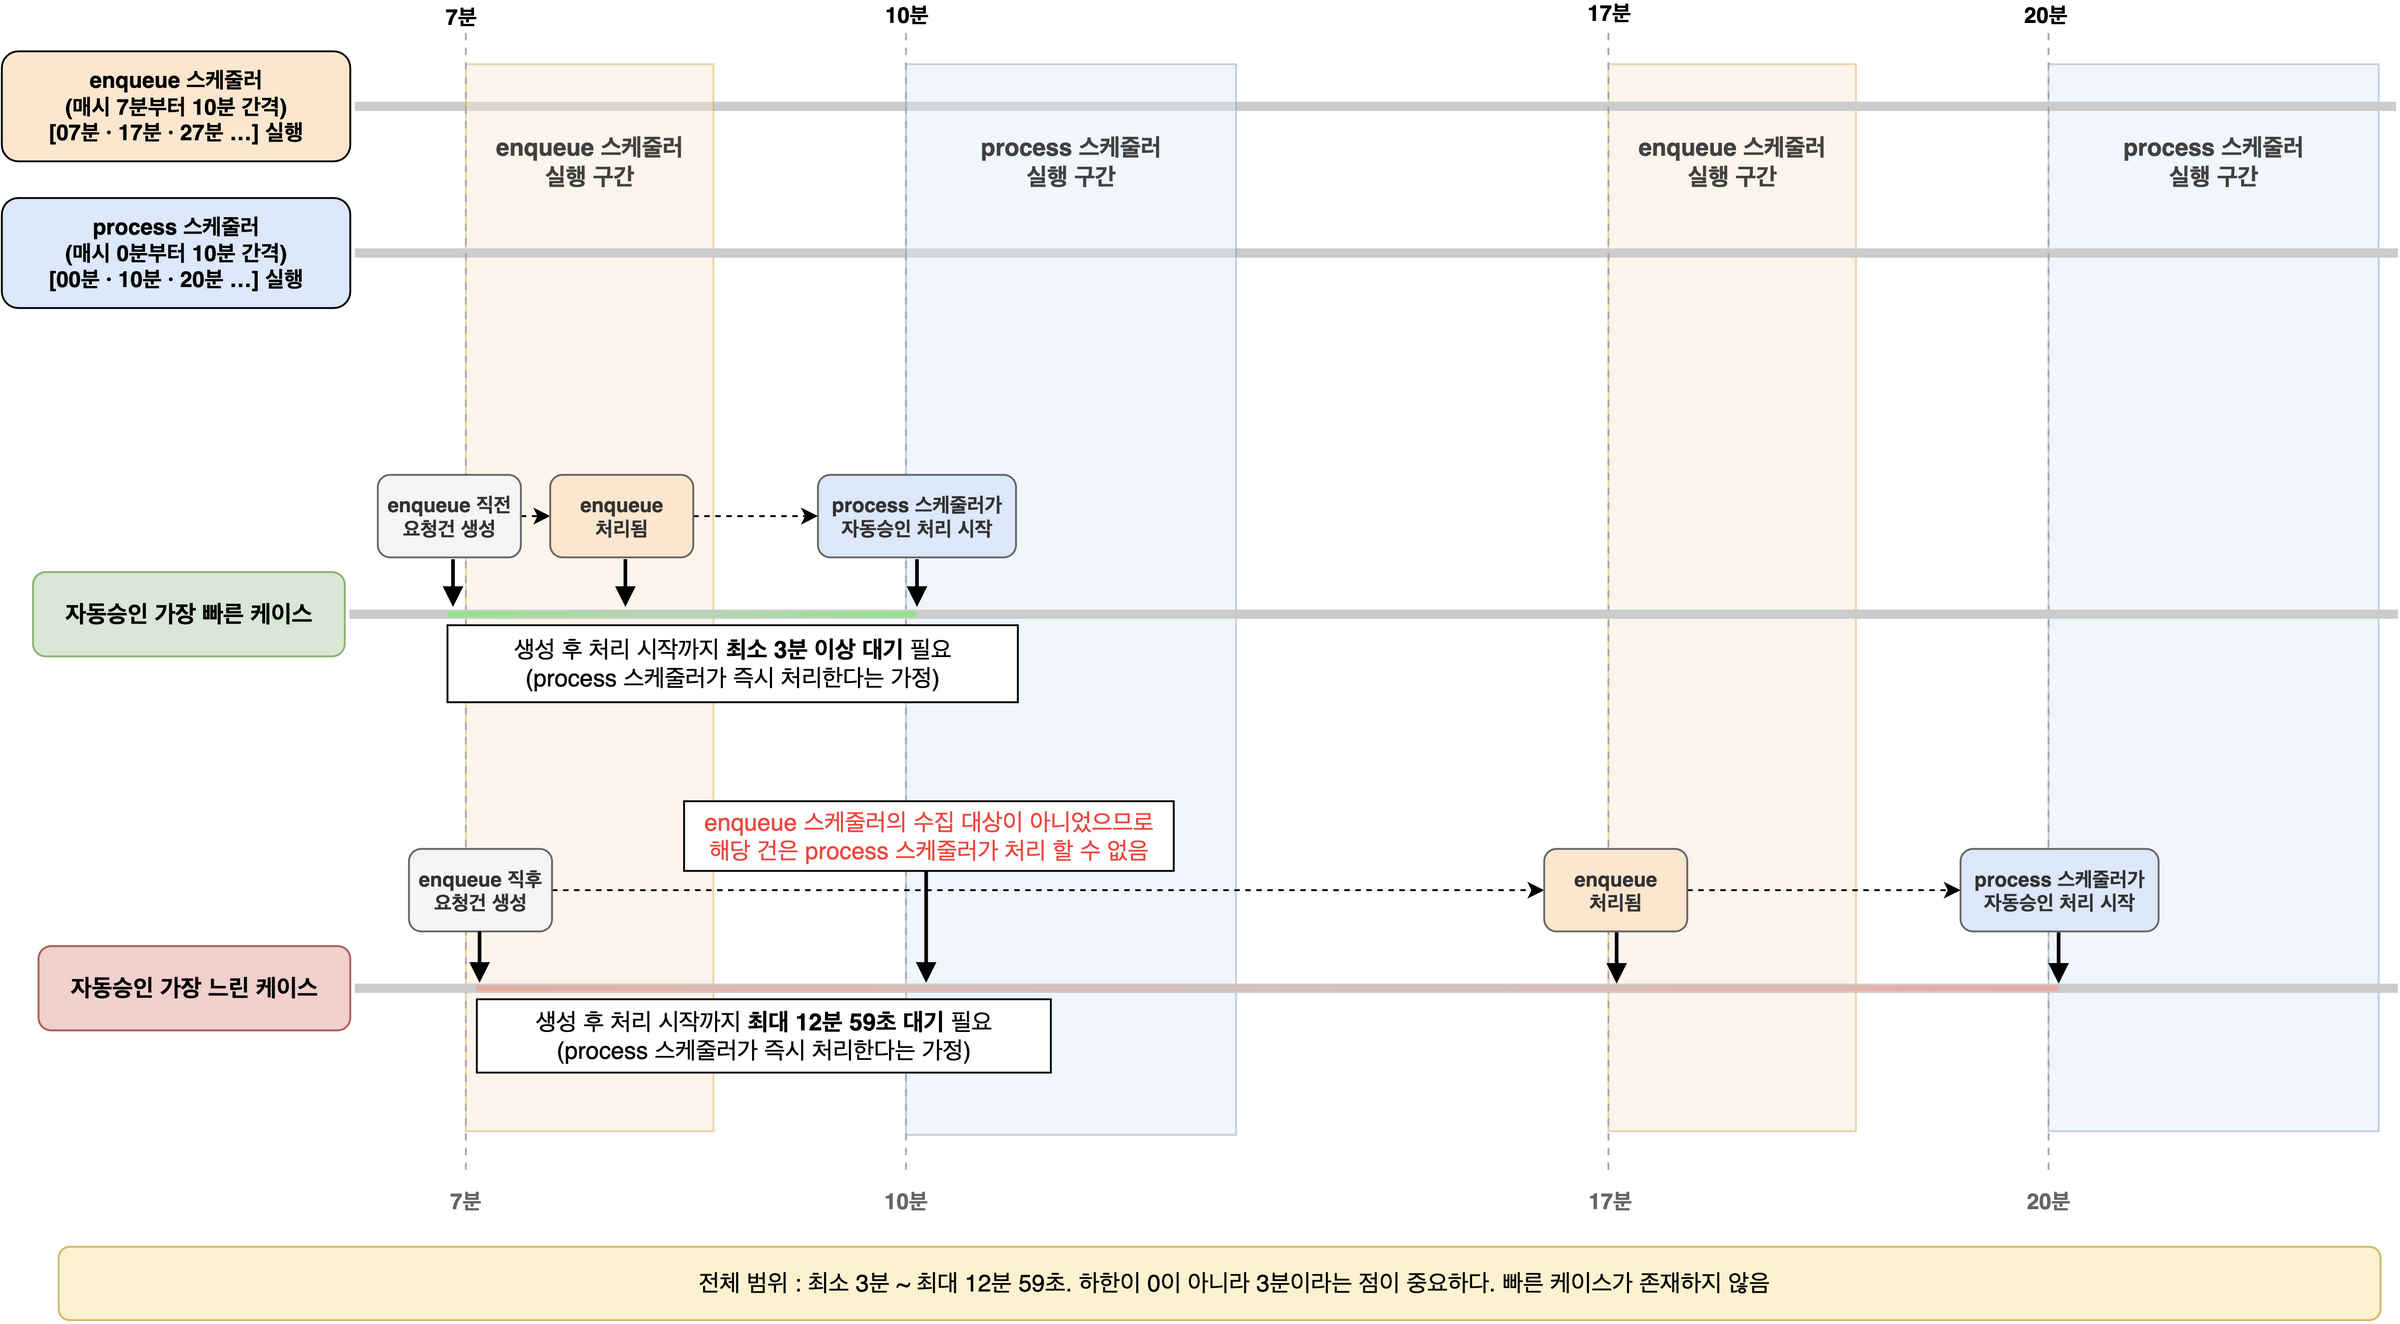
기존 자동승인은 두 개의 스케줄러로 나뉘어 있었습니다.
- enqueue(수집) 스케줄러: 매시 07분부터 10분 간격(07분, 17분, 27분 …)으로 요청건이 저장된
imr테이블에서 자동승인 후보를 찾아auto_approve_outbox테이블에NEW상태로 적재- enqueue에 주어진 시간은 다음 process 실행 전까지, 즉 3분
- process(처리) 스케줄러: 매시 00분부터 10분 간격(00분, 10분, 20분 …)으로
auto_approve_outbox를 읽어 실제 자동승인 처리- process에 주어진 시간은 다음 enqueue 실행 전까지, 즉 7분. 그리고 이 스케줄러의 실행 간격이 곧 재시도 간격이 되어 재시도 주기는 10분
이름은 아웃박스지만 메시지 발행용 Transactional Outbox는 아닙니다. 스케줄러 하나가 채우고 다른 하나가 비우는 DB 작업 큐입니다. 후보를 모으는 일과 처리하는 일을 분리해 두면 각각을 독립적으로 재시도하고 관측할 수 있습니다.
적재와 처리를 다른 시각에 두는 것 자체는 자연스럽습니다. 문제는 이렇게 벌려 놓은 간격이 그대로 고정된 대기 시간이 된다는 것입니다.
enqueue가 도는 07분에서 다음 process가 도는 10분까지 언제나 3분의 간격이 있습니다. 다음 그림이 그 3분이 생기는 과정을 시간 순서로 보여 줍니다.
이 3분은 가장 운이 좋아도 최소한 대기해야 하는 시간입니다. 빠른 경우가 아예 없었습니다.
쿼리도 무거웠습니다
후보 조회 쿼리는 조회 기준 시각을 현재로부터 일정 기간 전으로 잡고, 요청 상태가 "대기(PENDING), 재요청(RETRY), 진행(ING)" 중인 것만 봤습니다. 이미 완료된 건은 걸러졌습니다. 무거웠던 이유는 조건이 아니라 구조였습니다.
- 넓은 시간 범위를 커서 페이징으로 끝까지 훑었습니다. 과거에 생성되었더라도 상태가 바뀌어 현 시점에는 수집 대상이 될 수 있기에 일정 기간 범위 전체를 읽습니다.
NOT EXISTS (auto_approve_outbox)안티 조인(짝이 없는 행만 남기는 조인)을 썼습니다. 이미 큐에 들어간 건을 제외하려면 필요했습니다.- 복잡하고 거대한 구조의 전자계약서 원장을
INNER JOIN했습니다. 후보를 뽑는 시점에 필터까지 미리 하기 위해 상세 데이터를 끌어왔습니다. - 모든 후보 각각에 외부 API 호출이 붙었습니다. 뽑아 온 건마다 외부 시스템에 진행 상태 동기화를 요청했습니다. 조회 한 번의 비용이 DB 밖으로도 번졌습니다.
10분에 한 번, 한 대에서만 도는 동안에는 이 무거움이 문제로 드러나지 않았습니다. 문제는 주기를 줄이려는 순간입니다.
이 로직을 그대로 두고 주기를 줄이면 외부 시스템에 요청이 한꺼번에 몰리며, 우리 DB도 감당하지 못할 수 있습니다.
주기를 줄이기 위해 바꾼 것들
아웃박스 대기 큐를 걷어내는 것부터 시작해 일곱 가지를 바꿨습니다. A와 B는 조회를 가볍게 만들고 주기를 줄이는 일, C부터 F까지는 N대가 같은 건을 동시에 건드리지 않게 막는 일, G는 선점한 뒤 최신 상태로 처리하는 일입니다.
A. 아웃박스 대기 큐를 걷어냈습니다
가장 먼저 한 질문은 "폴링 주기를 얼마로 줄일까"가 아니라 "큐 역할로 사용할 아웃박스가 왜 필요했나"였습니다.
큐가 필요했던 이유는 후보를 찾는 일과 처리하는 일을 두 스케줄러로 나눠 두었기 때문입니다. 그리고 그 분리는 흔히 쓰던 배치의 방식을 그대로 따른 것이었습니다.
여기서 관점을 뒤집었습니다.
우리에게 필요했던 것은 "처리 대기 큐"가 아니라 "이 건을 이미 처리 중인가"를 알려주는 마커였습니다.
큐가 없어도 후보는 언제든 다시 계산할 수 있습니다. 후보를 가려내기 위한 요청의 현재 상태 정보는 imr 테이블에 있기 때문입니다. 필요한 건 "이미 선점한 건을 또 선점하지 않는 것"이고, 그건 큐가 아니라 상태 레코드로 해결됩니다.
그래서 자동승인 상태만을 관리하기 위한 별도 테이블 auto_approve_state를 새로 만들었습니다. 다음 그림이 후보 대상을 어떻게 걸러내는지 보여 줍니다.
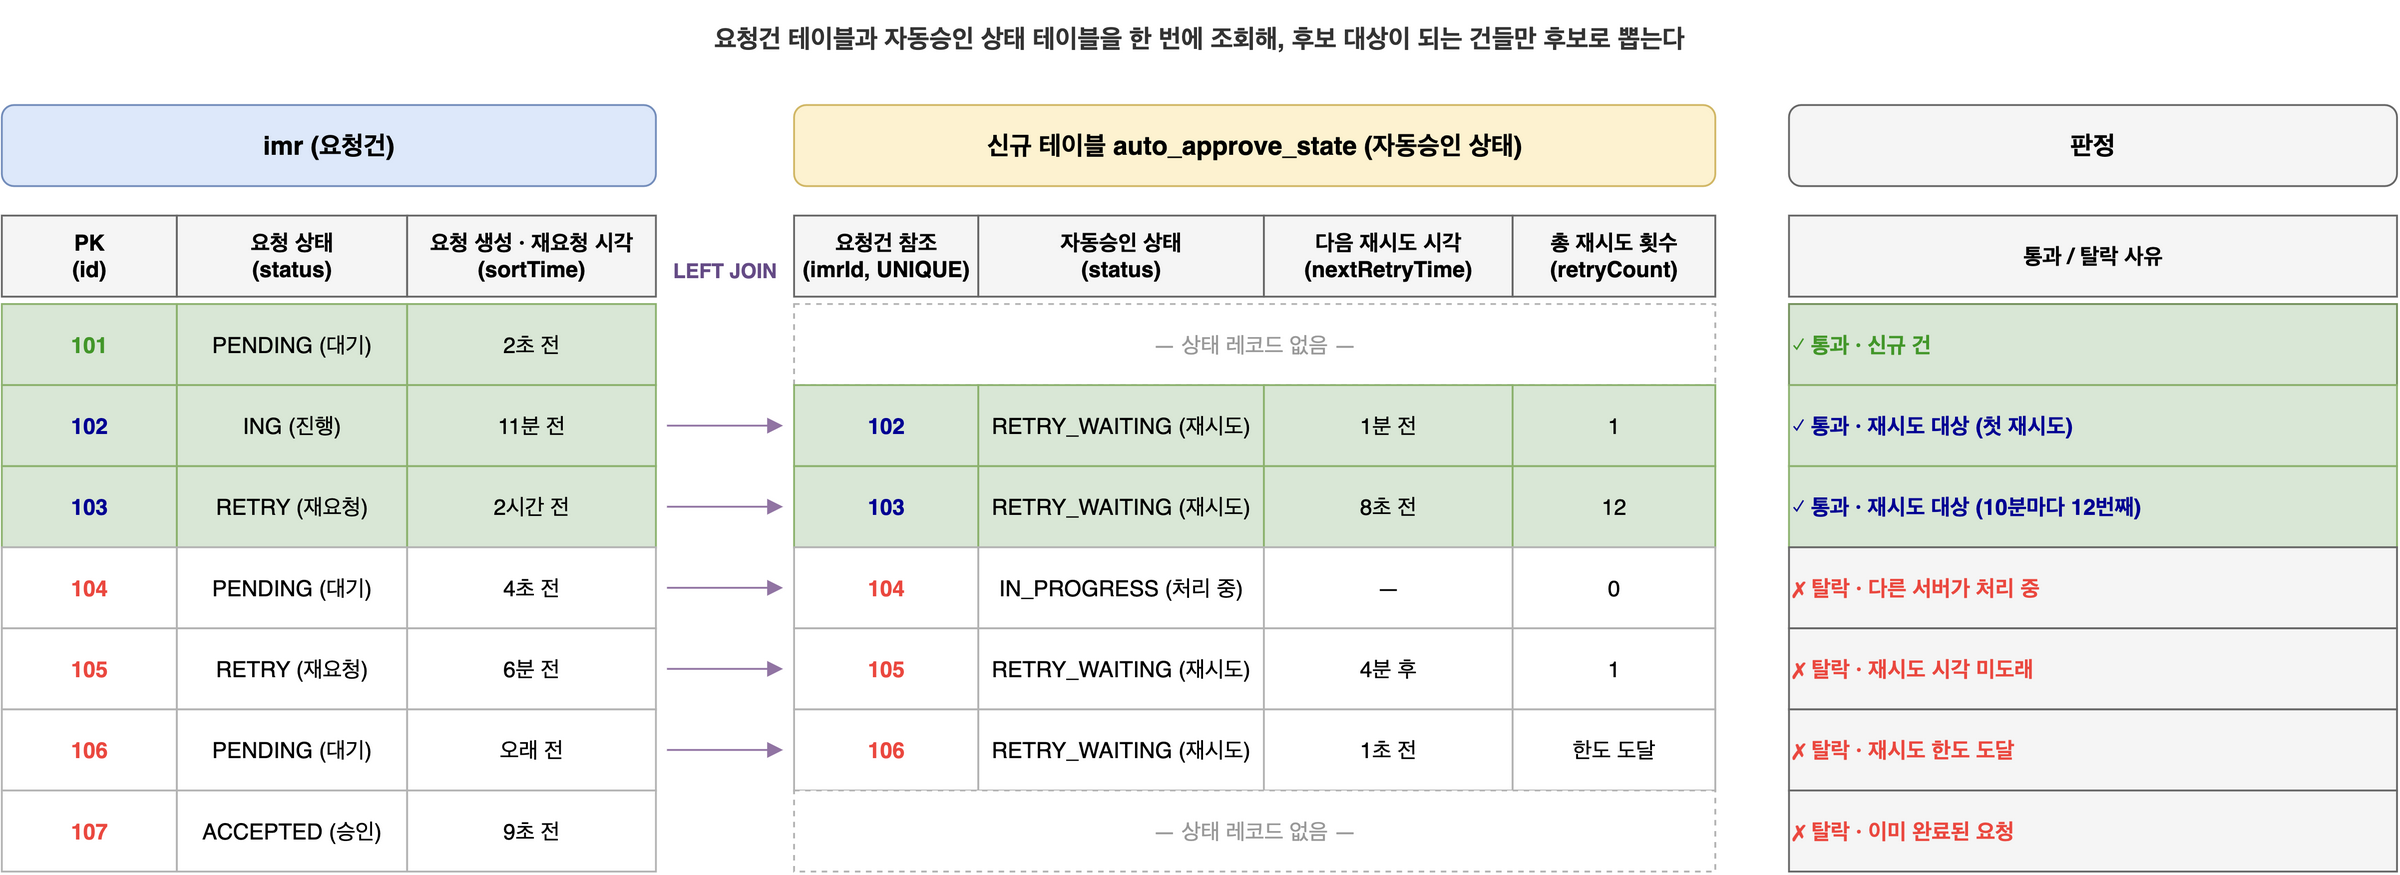
자동승인 대상은 업주계약과 광고계약 두 유형이라 조회 쿼리는 유형별로 한 번씩 실행합니다. 그 한 번이 "신규 대상"과 "재시도 대상"을 동시에 식별합니다. enqueue 스케줄러가 필요 없어졌고, NEW라는 적재 상태도 사라졌습니다. 상태는 두 개만 남았습니다.
enum class AutoApproveStateStatus {
    IN_PROGRESS,     // 지금 누군가 처리 중
    RETRY_WAITING,   // 조건 미충족으로 대기, nextRetryTime 이후 재시도
}
이름이 비슷한 두 상태를 미리 구분해 두겠습니다. 요청 상태(imr.status)의 RETRY는 반려된 요청이 다시 제출된 것이고, 상태 레코드의 RETRY_WAITING은 자동승인이 조건 미충족으로 다음 시도를 기다리는 것입니다. 다른 테이블의 다른 개념입니다.
전제가 셋입니다. 자동승인 대상 유형이고, 요청이 아직 미처리 상태(PENDING, RETRY, ING)이고, 최근 일정 기간 안에 있어야 합니다. 그 전제를 통과한 뒤 두 경우 중 하나면 후보가 됩니다.
- 짝이 되는 상태 레코드가 없는 신규 건
- 상태 레코드가
RETRY_WAITING이면서 다시 볼 시각이 지났고, 한도가 남아 있는 재시도 대상 건
그림에 있는 요청 일곱 건(101~107)이 각각 어디에 걸리는지 보면 이렇습니다.
- 101: 상태 레코드가 없습니다. 아무도 선점한 적 없는 신규 건이라 통과합니다.
- 102:
RETRY_WAITING이고 다시 볼 시각이 1분 전에 지났습니다. 첫 재시도로 통과합니다. - 103: 102와 같은 경우인데 열두 번째 재시도입니다. 재시도할 때마다 10분씩 밀린 결과라 요청은 두 시간 전에 들어왔습니다.
- 104:
IN_PROGRESS입니다. 다른 워커가 이미 선점하여 빠집니다. - 105: 다시 볼 시각이 4분 남았습니다. 그때까지는 조회에 잡히지 않습니다.
- 106: 재시도 한도에 도달했습니다. 시각은 지났지만 더 시도하지 않습니다.
- 107: 요청이 이미 승인돼 전제에서 걸립니다. 상태 레코드가 없는 것은 자동승인이 성공하면 행을 지우기 때문입니다.
통과한 건은 요청 상태 순서로, 같은 상태 안에서는 오래 기다린 것부터 앞에 옵니다. 업주계약 요청 20건, 광고계약 요청 10건까지 가져옵니다. 광고계약 요청은 가게가 있어야 한다는 조건이 하나 더 붙습니다.
성공하면 행을 삭제합니다. 상태 목록에 DONE이 없는 이유입니다. 이 테이블은 "처리해야 할 것"이 아니라 "이미 한 번 손을 댄 것"만 담습니다. 행이 생기는 시점은 어떤 워커가 그 건을 선점할 때입니다. 그래서 아직 아무도 선점하지 않은 신규 건은 여기에 없고, 행 수는 밀린 양이 아니라 처리 중과 재시도 대기의 합입니다. 그 안에는 요청 상태가 이미 바뀌었지만 아직 클렌징 스케줄러가 지우지 않은 행과, 재시도 한도에 걸려 멈춘 행도 섞여 있습니다.
"그냥 Kafka를 쓰면 되지 않나"
여기에서 당연히 나올 질문이 있습니다. 큐를 걷어낼 거면 아예 이벤트 기반으로 가지, 왜 폴링을 유지했을까요? 이벤트를 발행하고 컨슈머가 즉시 처리하면 폴링도, 지연도 없어 보입니다. 우리가 그 길을 택하지 않은 이유는 자동승인 조건의 성질 때문입니다.
자동승인 조건은 하나의 사건이 아니라 여러 시스템 상태의 조합입니다.
- 앞 단계 승인 완료
- 전자계약서 서명 완료
- 서류 검수 해제
- 운영 보류 없음
- 메뉴와 로고 등록
- …
이런 조건들은 업주, 가게, 광고 캠페인 각 승인 항목마다 모두 다릅니다.
여기에서 "전자계약서 서명 완료" 이벤트를 받아 처리하려 하면, 나머지 조건들이 아직 미충족일 때 할 수 있는 일이 없습니다. 이벤트를 버리고 다음 이벤트를 기다리면 된다고 볼 수도 있습니다. 그러려면 마지막 조건을 채우는 변화가 반드시 이벤트로 와야 하는데, 그 조건이 성립하지 않습니다. 전자계약서 진행 상태처럼 "우리가 손대지 않아도 외부 시스템과 동기화되며 갱신되는 값"이 있습니다. 마지막 한 칸이 그렇게 채워지면 깨워 줄 이벤트가 없습니다.
이벤트가 오면 즉시 처리하고, 놓친 건은 폴링이 주워 가는 하이브리드 형태의 방법도 있습니다. 얻는 것은 이벤트가 오는 조건에 한해, 길어야 10초입니다. 그 10초를 벌자고 같은 건에 들어오는 진입점을 하나 더 두면, 뒤에서 볼 선점과 중복 방어를 그 경로에도 똑같이 걸어야 합니다.
이 문제는 이벤트 처리가 아니라 상태 조정(reconciliation)입니다.
"승인 가능한 요청은 승인된 상태로 만들어야 한다"는 목표 상태가 있고, 현재 상태를 반복적으로 관찰해 목표에 수렴시킵니다. 쿠버네티스 컨트롤러의 재조정 루프와 같은 발상입니다.
이런 구조는 level-triggered입니다. 조건이 지금 true인지만 확인하기 때문에 어떤 신호를 놓쳐도 스스로 회복합니다. 회복 시점은 그 건을 다시 보는 시각입니다.
반대로 이벤트 기반은 edge-triggered입니다. 빠르지만 작업이 있다는 사실이 이벤트에만 담겨서, 이벤트를 놓치면 작업도 같이 사라집니다. 그래서 이벤트를 잃지 않기 위한 장치가 따로 필요합니다.
level-triggered는 요청의 현재 상태가 DB에 남아 있어서 그 장치가 없어도 됩니다.
다수 후보 조회는 얇게 하고, 건당 조회에서 상세히 합니다
앞에서 본 전자계약서 원장(esign_version) 조인을 후보 쿼리에서 떼어냈습니다. 후보 쿼리는 이전보다 느슨하게 "어떤 imrId를 확인해 볼 만한가"만 답하는 얇은 조회가 됩니다. 무거운 상세 조회(전자계약서 원장, 외부 시스템 진행 상태 동기화 등)는 락을 잡은 뒤 건별로, 병렬로 수행합니다.
- 후보 조회: 인덱스 조건 +
LIMIT로 한 턴 처리 건수에 상한, 결과는(imrId, imrType, stateId)세 컬럼 - 상세 조회: 처리하는 프로세서에서 건별 수행
이 후보 조회는 읽기 복제본이 받습니다. MySQL 8을 읽기용과 쓰기용으로 나눠 두었기 때문입니다. 복제본은 쓰기 DB보다 조금 늦으므로, 이미 남이 선점한 건이 그 시차 동안 아직 후보로 보입니다. 뒤에 나오는 중복 처리 이야기가 전부 여기서 시작합니다.
왜 기존 테이블을 재사용하지 않았나
역할이 바뀌었으므로 이름도 바뀌어야 한다고 판단했습니다. outbox는 "처리 대기 큐"를 뜻하는 이름인데, 새 구조에서 이 테이블은 큐가 아니라 요청별 처리 상태 추적 레코드입니다. 이름과 역할이 어긋난 테이블은 다음 사람을 헷갈리게 합니다.
그렇다고 단순히 이름만 바꾸는 것으로는 부족했습니다. 기존 테이블에는 더 이상 쓰지 않는 상태 값과 지난 구조의 연계 흔적이 남아 있었습니다.
새 테이블 auto_approve_state에는 앞의 큐와 달리 상태와 재시도 추적에 필요한 것만 남았습니다.
- 요청 참조(
imrId,UNIQUE여서 요청당 한 행) - 요청 유형
- 처리 상태
- 다음 재시도 시각
- 재시도 횟수
PK는 후보 조회 결과에 "stateId"라는 이름으로 실려 나오고, modifiedAt은 클렌징 스케줄러가 어떤 이유(장애, 배포 등)로든 멈춘 건을 찾을 때 사용합니다.
쓰는 인덱스는 둘입니다.
UNIQUE (imrId): 두 서버가 동시에 접근하는 레이스 컨디션으로 의도치 않게 상태 행이 두 개 생기는 것을 막습니다. 요청당 행이 하나뿐임을 DB가 보장합니다.(status, modifiedAt): 클렌징 스케줄러가IN_PROGRESS에서 멈춘 행을 찾을 때 씁니다.
여기에 조인이 읽는 컬럼을 모두 담은 (imrId, status, nextRetryTime, retryCount) 커버링 인덱스는 효과가 있을 것처럼 보입니다.
하지만 imrId에 UNIQUE가 있으면 옵티마이저는 UNIQUE 인덱스를 고릅니다. "최대 한 행"이 보장되면 조인에서 가장 싼 접근이 되고, 그 보장이 없는 커버링 인덱스는 힌트로 강제해도 더 느렸습니다. 이 테이블은 처리 중과 재시도 대기만 담아 누적되지 않으니 PK를 한 번 더 타는 비용 자체가 작다는 점도 작용합니다. 읽기 이득은 없고 쓰기 비용만 늘어납니다.
정리하면, 채우는 스케줄러와 비우는 스케줄러로 나뉘어 있던 구조가 후보 조회부터 처리까지 하는 스케줄러 하나로 합쳐졌습니다.
B. 폴링 주기를 10분에서 10초로
큐를 걷어내고 후보 쿼리를 가볍게 만들었으니, 이제 주기를 줄이면 됩니다. 10분에서 10초로, 1/60입니다.
// fixedDelay 속성에는 컴파일 타임 상수만 넣을 수 있다. 주기는 전 서버 동일하게 10초.
// initialDelayString의 SpEL은 기동 시 한 번 평가된다. 서버마다 다른 첫 실행 시점이 뽑혀 고정된다. (왜 무작위인지는 뒤에서)
@Scheduled(
    fixedDelay = 10000L,
    initialDelayString = "#{ T(java.util.concurrent.ThreadLocalRandom).current().nextLong(0, 10000) }",
)
fun autoApproveFlowExecutorScheduler() {
    // 자동승인 처리 시작
}
여기서 멈추면 장애로 이어집니다. 자동승인 대상의 성질을 먼저 봐야 합니다. 앞의 후보 조회가 "다시 볼 시각"을 조건으로 들고 있던 이유도 여기서 나옵니다.
후보로 잡히는 건은 두 종류입니다.
- 이번에 처음 조건을 만족한 신규 건
- 조건이 아직 충족되지 않아 재시도를 기다리는 건
요청 자체는 앞쪽이 대다수지만 한 턴 만에 빠져나가고, 후보 목록에 계속 남아 있는 것은 뒤쪽입니다. 앞 단계 승인이 안 끝났거나 서류 검수가 안 풀린 건들은 상황이 바뀌기 전까지 몇 시간에서 하루 넘게 계속 후보로 잡힙니다. 무한정은 아닙니다. 재시도 횟수에 한도가 있어 거기에 도달하면 후보에서 빠집니다.
폴링 주기만 1/60로 줄이면 어떻게 될까요. 재시도 대기 건을 다시 보는 간격도 10분에서 10초가 됩니다. 재시도 한 번에는 외부 시스템 조회가 여러 번 발생합니다. 전자계약서 상태 동기화, 가게 관리 시스템 조회, 광고 시스템 조회 같은 조회성 요청들이 전부 60배가 되며, 우리 지연 시간을 줄이려고 다른 시스템을 60배로 두드리는 셈입니다.
폴링 주기와 재시도 주기는 다른 문제입니다.
폴링 주기는 "새로 생긴 일을 얼마나 빨리 발견하는가"이고, 재시도 주기는 "실패한 일을 얼마나 자주 다시 시도하는가"입니다. 기존 구조는 이 둘이 같은 값에 묶여 있었기 때문에 한쪽만 바꿀 수 없었습니다.
그래서 둘을 분리했습니다. 재시도 시각을 상태 레코드가 직접 들고 있게 만들었습니다. 재시도로 빠질 때 하는 일은 셋입니다.
status를RETRY_WAITING으로 변경retryCount를 1 증가nextRetryTime을 10분 뒤로 이동
후보 쿼리는 nextRetryTime < 현재시간 조건을 갖고 있으므로, 재시도 대기 건은 그 시각이 지나기 전까지 조회 결과에서 아예 빠집니다. 결과적으로 이렇게 되었습니다.
- 신규 건 발견은 10초 안에
- 실패 건 재시도는 기존과 동일한 간격으로 유지
외부 시스템에 가는 부하는 늘지 않았습니다. 후보를 뽑을 때마다 건건이 붙던 외부 시스템 호출을 처리 단계로 옮겼기 때문입니다. 이제 그 호출은 선점해서 실제로 처리하는 건에만 붙습니다.
이 분리는 신규 건의 자리를 확보합니다
한 번에 가져오는 후보 수에는 상한이 있습니다. 업주계약 요청 20건, 광고계약 요청 10건으로 한 턴에 최대 30건입니다. 만약 재시도 대기 건이 10초마다 다시 후보로 올라온다면, 만성적으로 실패하는 건들이 이 30칸을 계속 차지해 새로 들어온 건이 뒤로 밀립니다. 전형적인 head-of-line blocking입니다.
그 점유가 언젠가 끝나기는 합니다. 재시도 한도가 있으니까요. 다만 끝나는 방식이 더 나쁩니다. 10초 간격이면 한도가 순식간에 소진됩니다. "서류 미제출"처럼 며칠이 걸리는 건은 조건이 갖춰지기 한참 전에 한도를 다 쓰고 자동승인 대상에서 빠집니다.
nextRetryTime을 뒤로 밀어 두는 것은 실패한 건을 그 기간만큼 대기열에서 빼내는 장치입니다. 지연 시간 최적화를 위해 넣은 값이 아니라, 처리 슬롯을 신규 건에 양보하는 값입니다.
cron이 아니라 fixedDelay를 쓴 이유
이 스케줄러는 워커 서버 N대에서 모두 돕니다. 만약 cron으로 "매 10초"를 지정하면 N대가 같은 순간에 깨어납니다. 모두 같은 쿼리를 실행하고, 같은 상위 30건을 보고, 같은 락을 동시에 잡으려 합니다. 경합이 최대가 되는 설정입니다.
fixedDelay는 이전 실행이 끝난 시점부터 10초를 셉니다. 서버마다 처리 시간이 조금씩 다르므로 실행 시각이 자연스럽게 흩어집니다. 시간이 지날수록 서로 엇갈리게 되고, 락 경합 확률이 떨어집니다. 별도 조율 장치 없이 얻는 이득입니다.
다만 이 분산에는 빈틈이 있습니다. 배포 직후에는 서버들이 거의 동시에 시작하므로 실행 시각도 나란히 시작합니다. 게다가 처리할 후보가 없는 한가한 시간대에는 턴 길이가 균일해서, 실행 시각이 흩어지는 속도도 느립니다.
그래서 첫 실행 시점은 서버마다 다르게 랜덤으로 정해집니다. 이 장 첫 코드에서 본 것처럼 initialDelayString에 SpEL을 씁니다. 이 표현식은 기동 시 한 번만 평가되므로, 서버마다 다른 초기 지연이 뽑혀 그 서버의 첫 턴 시각이 됩니다. 상한을 주기와 같게 두어 첫 실행 시점이 한 주기 전체에 걸쳐 흩어지도록 했습니다. 폴링 주기 자체는 fixedDelay로 전 서버 동일하게 10초입니다.
자연히 흩어지기를 기다리는 대신, 처음부터 흩어진 채로 시작하게 만든 것입니다. 랜덤 값이 작게 뽑혀도 문제가 없습니다. 주기가 아니라 초기 지연이므로 "거의 즉시 시작"일 뿐입니다.
왜 10초인가
정밀한 벤치마크로 뽑은 값은 아닙니다. 다만 이 값을 정할 수 있는 범위는 있습니다.
너무 짧으면 빈(empty) 조회가 잦아집니다
후보가 없으면 턴은 조회 한 번으로 끝납니다. 그래서 한가한 시간대에는 주기가 곧 조회 횟수가 됩니다. 주기를 아주 짧게 잡으면 얻는 것 없이 빈손으로 돌아오는 조회만 늘어납니다.
또한 처리할 후보가 있는 동안에는 주기를 줄여도 별 효과가 없습니다. fixedDelay는 이전 실행이 끝난 시점부터 세고, 한 턴은 병렬 처리가 전부 끝날 때까지 반환하지 않습니다. 자동승인 한 건은 외부 시스템 호출이 여러 번 이어지는 작업이라 수 초가 걸리므로, 사이클이 이미 그 시간에 묶여 있습니다.
그래서 한 서버의 턴 간격은 폴링 주기보다 길어질 수 있습니다. 다만 워커 N대가 각자 독립적으로 돌기 때문에, 한 대가 처리에 붙잡혀 있어도 다른 대가 이어받습니다.
너무 길면 처리량이 줄어듭니다
앞에서 본 것처럼 한 턴에 가져오는 후보 수에는 상한이 있습니다. 폴링 주기가 길어지면 단위 시간당 처리할 수 있는 양도 그만큼 줄어들고, 유입이 그 선을 넘으면 후보가 밀립니다. 한번 밀리기 시작하면 실제 지연은 폴링 주기보다 커집니다.
그리고 이 기능의 목적이 상한을 정하기도 합니다. 조건이 갖춰진 뒤 분 단위로 기다려야 한다면 그 건은 그동안 담당자 목록에 남아 있고, 서론에서 말한 대로 사람이 먼저 손을 대게 됩니다. 그러면 자동승인을 만든 이유 자체가 옅어집니다.
그 사이라면 어디든 됩니다. 후보 쿼리 한 번이 수 밀리초에 끝나기 때문입니다. 요청 테이블에 (status, type, sortTime) 인덱스가 있고, 후보 쿼리의 조건과 ORDER BY가 이 컬럼 순서와 동일합니다. 그래서 요청 테이블 쪽은 정렬 없이 인덱스 범위만 읽습니다.
읽은 행마다 상태 테이블로 조인 룩업이 한 번씩 붙고, 한 번의 비용은 대부분 그쪽에서 나옵니다. 10초는 그 구간에서 기억하기 쉬운 값을 고른 것에 가깝습니다. 다만 한 번이 싸다는 것과 총량이 싸다는 것은 다릅니다. 주기를 줄이면 그만큼 실행 횟수가 늘고, 그 부담은 그대로 우리 DB에 남습니다.
파라미터가 민감하지 않다는 것 자체가 설계의 결과입니다.
재시도 주기를 폴링 주기에서 떼어냈고, 후보 조회를 한 단계로 줄여 한 번이 수 밀리초에 끝나게 만들었고, 중복 처리를 주기가 아니라 락과 상태로 막았습니다. 이 셋이 갖춰지고 나서야 "10초쯤"이라고 말할 수 있게 됩니다. 파라미터를 정밀하게 고를 필요가 없는 구조를 만드는 편이 파라미터를 잘 고르는 것보다 낫습니다.
C. 같은 건이 두 번 처리되는 동시성 문제
스케줄러가 N대에서 동시에 돌고, 모두 같은 쿼리를 실행합니다. 같은 후보 목록을 손에 들고 같은 요청을 처리하게 된다는 뜻입니다. 그대로 두면 한 요청이 두 번 처리되고, 외부 시스템에 같은 요청이 두 번 나갑니다.
가장 쉬운 답은 ShedLock(여러 서버에서 동일한 스케줄링 작업이 중복으로 실행되지 않도록, 분산락으로 한 서버에서의 실행만을 보장하는 라이브러리) 같은 도구로 N대 중 1대만 실행하게 하는 것입니다. 개선 전 구조가 그랬고, 많은 배치성 스케줄러가 그렇게 합니다. 서버를 늘려도 자동승인 처리량은 늘지 않습니다. 몇 대를 띄워도 실제로 도는 것은 1대이기 때문입니다. 그 1대가 죽으면 다음 락 만료까지 자동승인 전체가 멈춥니다. 준실시간을 목표로 하는 기능에서 단일 실행자는 병목이자 단일 장애점입니다.
그래서 N대 전부 실행하되, 한 건을 여러 서버에서 동시에 처리하지 못하게 했습니다. 락의 단위를 "스케줄러"에서 "요청 한 건"으로 내렸습니다.
그 선점을 무엇으로 구현할지가 다음 문제였습니다. 선택지는 셋이었습니다.
| 방식 | 선점 단위 | 얻는 것과 잃는 것 |
|---|---|---|
| Redis 락 (채택) | 요청 한 건 | 실패한 선점이 Redis에서 끝나 쓰기 DB에 도달하지 않는다. 대신 선점 판정과 상태 기록이 두 저장소로 나뉘어, 그 사이를 락으로 묶어야 한다. |
| DB 조건부 UPDATE | 요청 한 건 | 선점 판정과 상태 기록이 한 연산이라 락이 아예 필요 없다. 대신 실패한 시도까지 항상 쓰기 DB에 도달해야 하고, 앞 서버가 커밋할 때까지 기다린 뒤에 실패를 받는다. |
| DB SKIP LOCKED | 조회 단위 요청 다건 | 경합이 아예 없고 트랜잭션도 짧다. 대신 요청 테이블이 잠긴다. 우리 후보 조건으로는 잠기는 범위를 LIMIT 개수로 좁힐 수 없다. |
DB 두 방식을 확인해봤습니다
셋 다 중복 처리를 막자는 접근입니다. 정해야 할 것은 "되는가"가 아니라 "무엇을 대가로 내는가"였습니다. 표의 마지막 열에서 두 DB 방식 쪽이 어디서 나왔는지부터 보겠습니다. 운영과 같은 스키마와 인덱스에 후보 쿼리를 그대로 올리고, 버전과 격리 수준까지 맞춘 MySQL 8에 두 세션을 붙여 재현했습니다.
조건부 UPDATE
UPDATE auto_approve_state
   SET status = 'IN_PROGRESS'
WHERE imrId = ? AND status = 'RETRY_WAITING';- 바뀐 행이 1이면 선점, 0이면 다른 서버가 먼저 선점입니다. 신규 건은 상태 레코드가 없으니
INSERT가 그 역할을 합니다. 한 서버만 성공하고 나머지는 중복 키 오류를 받습니다. - 선점 판정과 상태 기록이 한 연산입니다. 그래서 락을 처리가 끝날 때까지 붙잡을 이유가 없어집니다. 뒤늦게 선점하려 해도 바뀐 행이 0이거나 중복 키를 받고, 복제 지연도 문제가 되지 않습니다.
- 요청 테이블을 건드리지 않습니다. 잠기는 것은 그 요청의 상태 행 하나뿐이고, 한 세션이 그 행을 잡고 있는 동안에도 같은 요청에 대한 사용자 쪽 쓰기는 그대로 통과했습니다.
- 대가 하나. 선점에 실패한 시도까지 전부 쓰기 DB에 도달합니다.
- 대가 둘. 즉시 선점 여부를 받지 못합니다. 앞선 서버가 커밋해야 0행이나 중복 키를 받습니다. 선점 트랜잭션을 짧게 유지하면 그 대기는 짧지만, 기다려야 한다는 것 자체는 없앨 수 없습니다.
SKIP LOCKED
후보 조회 자체가 선점이 되므로 N대가 애초에 서로 다른 후보를 가져갑니다. 경합이라는 개념이 사라지고, 트랜잭션을 내내 열어 둘 필요도 없습니다. 선점해서 IN_PROGRESS로 바꾸고 커밋하면 락은 거기서 끝나고, 그다음부터는 상태값이 선점을 대신합니다.
결론부터 적으면 SKIP LOCKED는 스캔이 LIMIT에서 멈출 수 있을 때 의미가 있습니다. 선점 조건과 정렬이 한 테이블의 인덱스로 전부 만족되면 잠기는 것이 정확히 LIMIT 개수입니다. 같은 스키마에 재시도 시각 인덱스를 만들고 그 순서로 던져 보면 다섯 건을 선점할 때 정확히 다섯 행만 잠기고, 두 번째 세션은 그다음 다섯 건을 받습니다. 반대로 정렬만 인덱스와 어긋나게 줘도 조건에 걸리는 범위 전체가 잠기고 두 번째 세션은 빈손으로 돌아옵니다.
우리 후보 조건은 그 형태로 만들 수 없습니다. 조건 일부가 조인 뒤에 걸리기 때문입니다. 그렇게 만들려면 후보를 미리 담아 두는 테이블이 있어야 하고, 그건 이미 걷어낸 아웃박스 큐입니다.
재현에서 본 것은 아래와 같습니다.
- 후보가 중복되지 않게 잘 나뉘었습니다. 한 세션이 20건을 선점한 상태에서 다른 세션은 겹치지 않는 다음 20건을 받았습니다.
LIMIT는 잠금을 제한하지 않습니다. MySQL은 반환한 행이 아니라 훑은 행을 잠급니다(MySQL Manual). 그래서 스캔이LIMIT에서 멈추지 못하고, 선점한 것은 20건인데 잠긴 것은 394행이었습니다. 정렬 탓이 아닙니다. 실행 계획은 운영과 같은 커버링 인덱스 스캔이었고 파일 정렬도 없었습니다.REPEATABLE READ에서는 넥스트키 락이 범위 경계까지 넘어가서, 자동승인이 보지도 않는 유형의 요청까지 잠겼습니다.- 이 테이블은 잠기면 안 됩니다. 자동승인이 보는 것은 업주계약과 광고계약 둘뿐이지만, 요청 테이블에는 12가지 요청 유형이 함께 들어 있고 상태 변경, 담당자 배정, 수동 승인처럼 요청을 고치는 쓰기가 모두 이 테이블을 지납니다. 잠긴 행에 사용자 쪽 쓰기를 넣으면 대기 시간을 넘겨 실패했습니다.
READ COMMITTED로 내리면 넥스트키 락에서 빈틈을 잠그는 부분이 빠져 다른 유형으로 번지는 것은 멈춥니다. 다만 스캔이 훑은 수백 행에 걸리는 레코드 락은 그대로라, 이 테이블이 잠긴다는 사실 자체는 달라지지 않습니다. - 잠금을 상태 테이블로 좁히면 선점이 아예 동작하지 않습니다.
FOR UPDATE OF로 범위를 좁히면 요청 테이블은 잠기지 않지만,LEFT JOIN에서 건너뛴 행이 사라지지 않고 오른쪽이 비어 있는 행으로 돌아옵니다. 우리 조건에서 그건 "신규 건"을 뜻해서, 두 세션이 완전히 같은 20건을 받았습니다.
그래서 Redis로 선점합니다
조건부 UPDATE와 SKIP LOCKED, 두 대안의 대가를 비교해보고 Redis로 정했습니다.
첫째, 실패한 선점의 비용이 어느 축에 비례하는가입니다. 락 획득 실패는 Redis에서 끝나고, 기다리지도 않습니다. 기다려 봐야 처리량만 깎입니다. 어차피 늦어도 10초 안에 또 폴링합니다. 쓰기 DB로는 락을 잡은 서버만 갑니다. 재확인 한 번과 상태 기록 한 번입니다. 즉 쓰기 DB가 받는 양은 실제 처리 건수가 정합니다. 조건부 UPDATE는 실패한 시도까지 쓰기 DB로 보내므로, 그 양이 폴링 횟수와 서버 대수에 비례합니다. 이번에 1/60로 줄인 것이 바로 폴링 횟수입니다.
둘째, 실패를 언제 아는가입니다. 조건부 UPDATE에서는 앞 서버가 커밋해야 내 실패를 알 수 있습니다. 짧게 유지해도 한 세션이 느려지면 그 지연이 같은 건을 노리는 다른 서버로 그대로 번집니다. Redis에서는 앞 서버가 느려도 뒤 서버가 붙잡혀 있지 않습니다. 즉시 실패를 받고 다음 후보로 갑니다.
대가도 분명합니다. 선점 기록은 Redis에 있고, 그 건을 후보에서 빼는 판정은 DB가 합니다. 두 저장소가 서로를 모르기 때문에 선점 판정과 상태 기록 사이를 락으로 묶어야 하고, 락 만료 시간이 처리보다 먼저 끝나는 상황이 생깁니다. 다만 이 복잡도는 한 번 만들고 나면 고정입니다. 조건부 UPDATE가 내는 쓰기 DB 부하는 주기를 줄일수록 커집니다. 쓰기 DB에 여유가 있다면 조건부 UPDATE가 더 단순합니다. 다만 조건부 UPDATE로 주기를 1/60로 줄이는 것이 곧 그 여유를 쓰는 일입니다.
D. 락이 풀리거나 서버가 중단될 때
Redis 락으로 선점하기로 했지만, 락 하나가 선점을 결정하지는 않습니다. 락에는 만료 시간이 있고, 서버는 장애나 배포로 다운될 수 있습니다.
선점은 세 단계가 붙어 있는 한 구간에서 결정됩니다. 락을 잡고, 상태 행을 다시 보고, IN_PROGRESS를 기록합니다. 그 뒤는 처리가 어떻게 끝나는지에 따라 그림처럼 세 가지 경우로 나뉩니다.
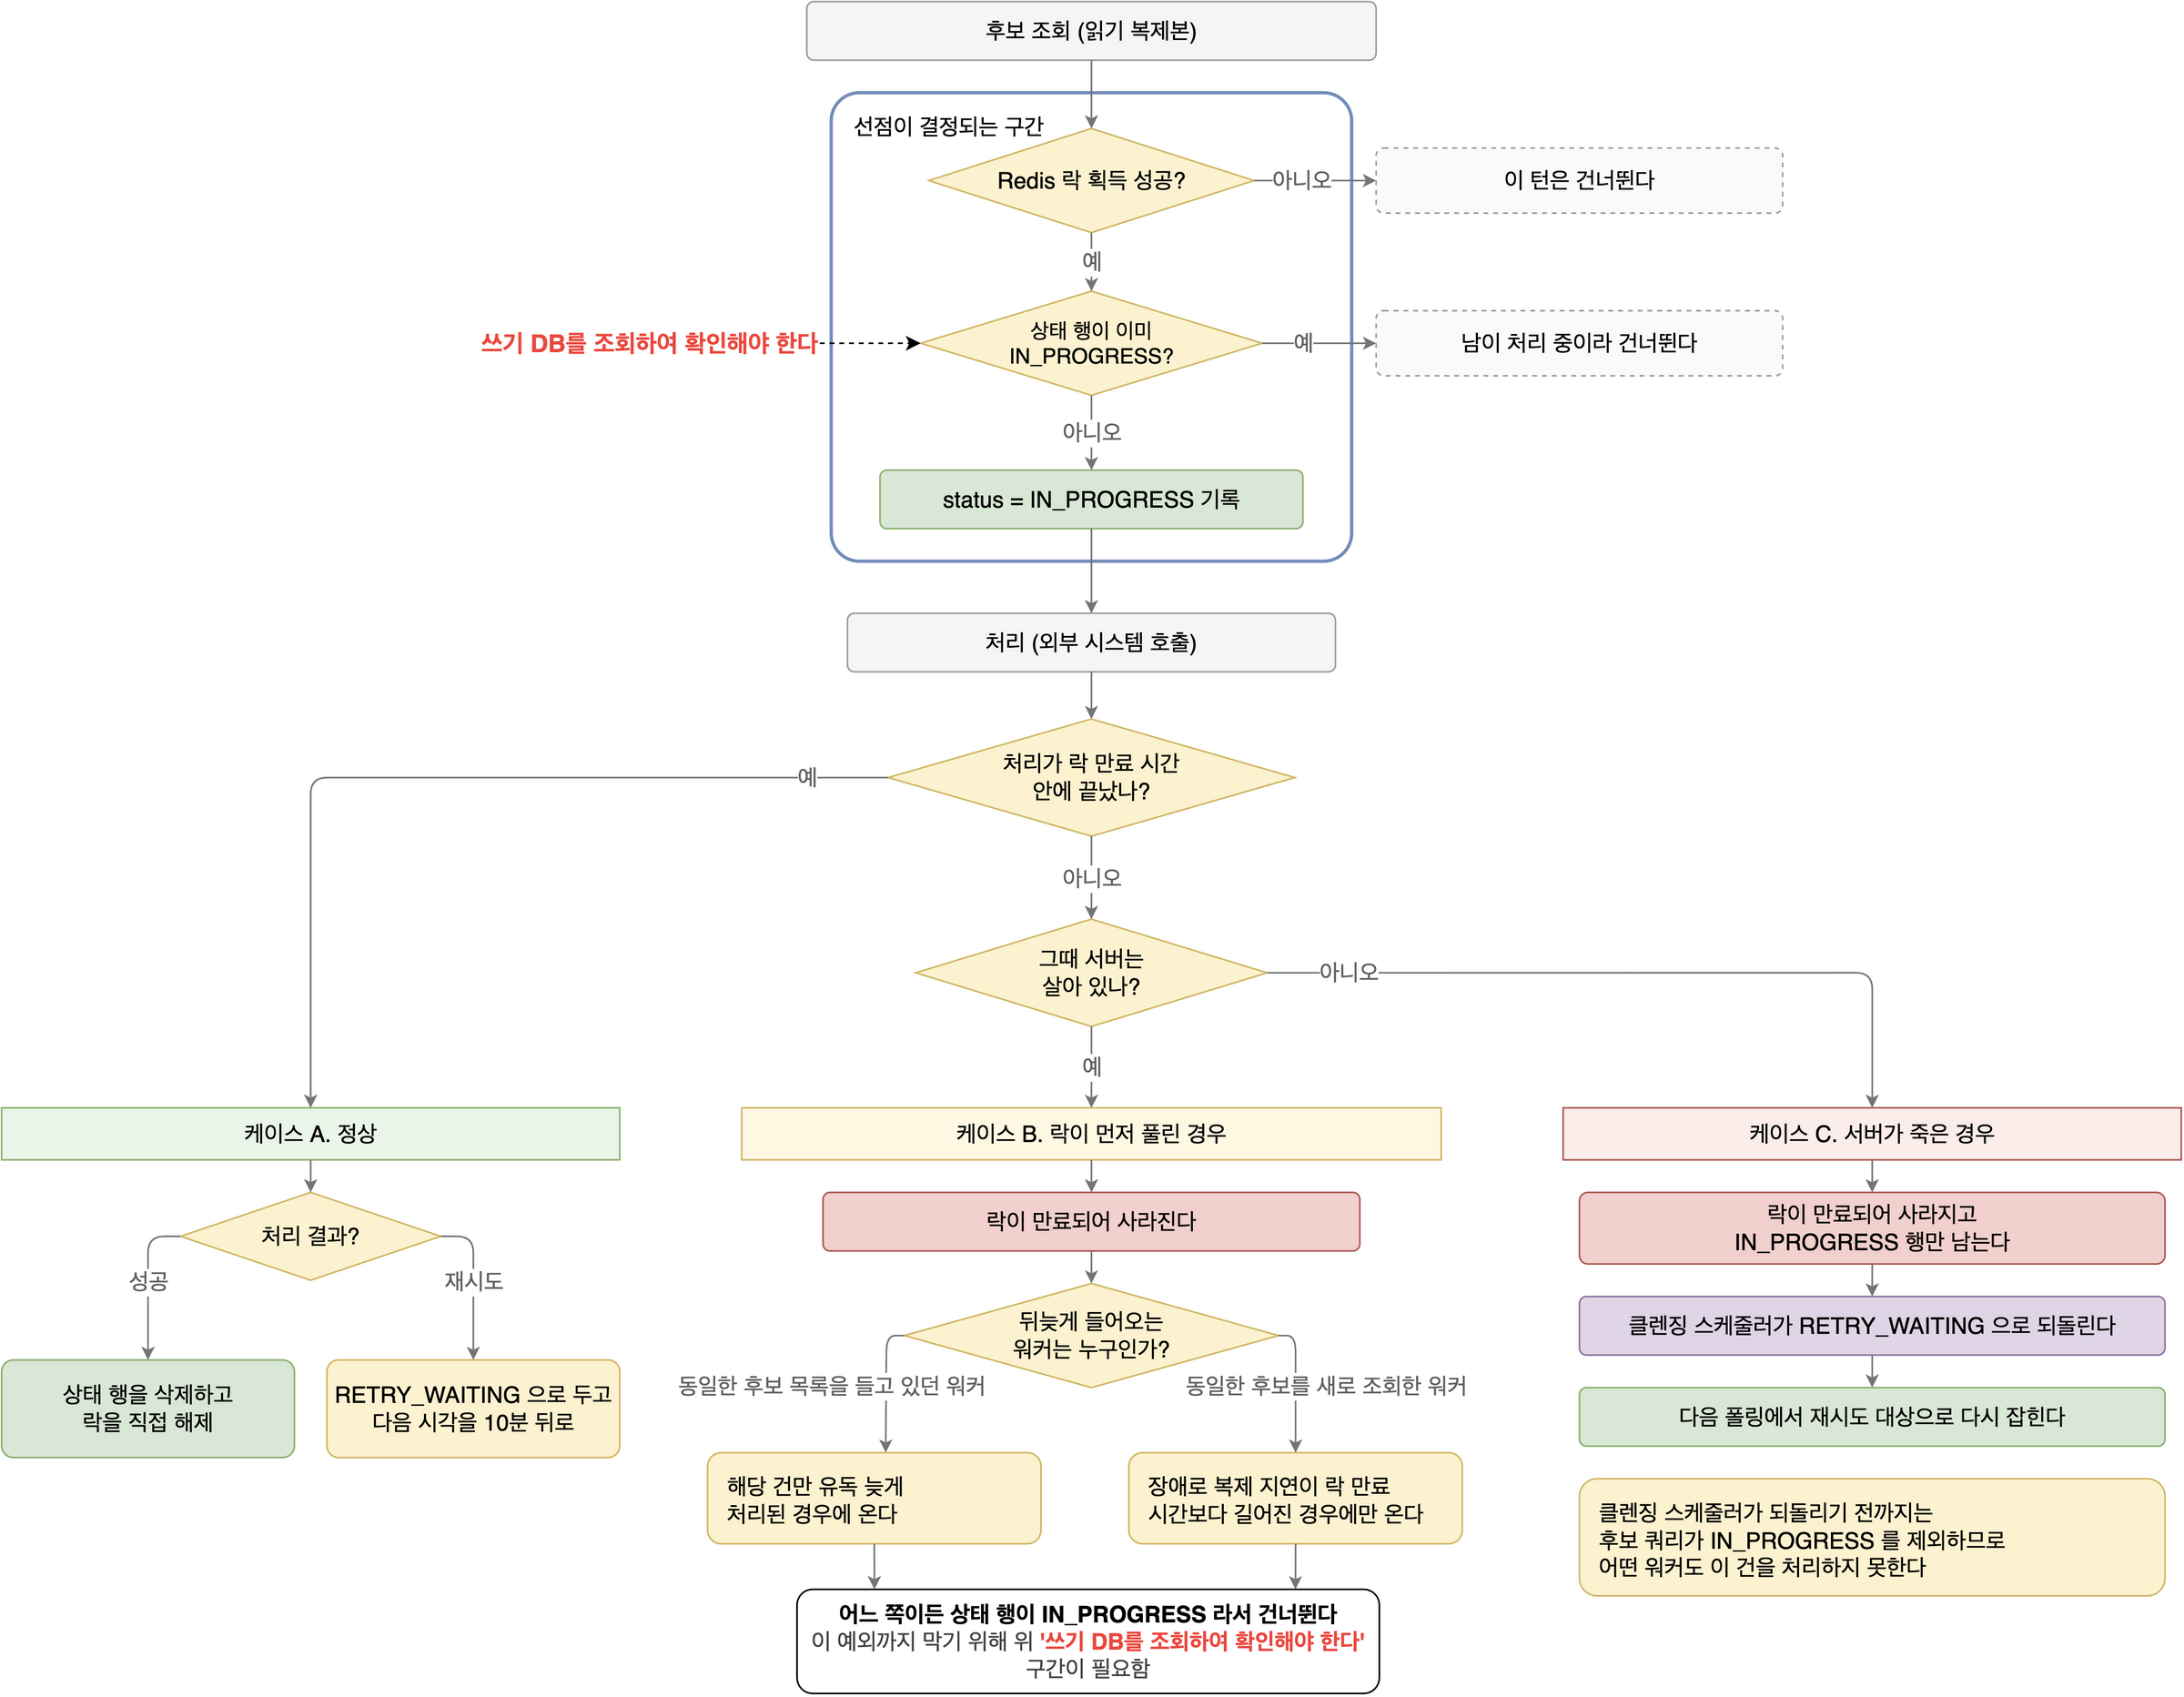
상태 행 재확인은 쓰기 DB에서 읽어야 합니다. 복제 지연이 이 문제를 만든 원인인데, 재확인이 복제본을 보면 그대로 무력화됩니다.
락이 처리보다 먼저 풀릴 때
락이 먼저 풀려도 새로 조회하는 워커는 중복 후보를 가져오지 않습니다. 후보 쿼리가 IN_PROGRESS를 빼기 때문입니다. 가져올 수 있는 상황은 그 기록이 복제본에 반영되기 전에 조회를 끝냈을 때뿐입니다. 새로 조회한 워커라면 복제 지연이 락 만료 시간보다 길어야 하는데, 평상시 복제 지연은 거기에 한참 못 미칩니다.
락이 만료되기 전 동일한 후보를 조회하여 갖고 있던 워커는 복제 지연과 무관합니다. 대신 그 건이 유독 늦게 처리되고 있어야 합니다.
그렇게 들어온 워커는 재확인에서 그 건을 건너뜁니다. 앞 워커가 처리 중이면 IN_PROGRESS가 보이고, 이미 성공해서 상태 행을 지웠으면 행 자체가 없습니다. 둘 다 재확인이 걸러 냅니다. 통과하는 경우는 앞 워커가 재시도로 끝냈을 때뿐이고, 그때는 처리 프로세서마다 도는 재조회의 nextRetryTime 조건에 걸립니다.
Redis가 없으면 아무것도 못 하지만, 잘못하지도 않습니다.
선점을 Redis에 맡겼으니 Redis가 죽으면 락 획득이 실패로 끝나고, 그 건은 그 턴에서 빠집니다. 다만 끊기는 지점이 락이라 DB에는 아무 흔적도 남지 않습니다. 처리하다 만 상태가 생기지 않고, 그 건은 다음 턴에 다시 후보로 올라옵니다.
락을 못 잡았을 때 그냥 진행하는 폴백을 둘 수도 있었으나, 두지 않았습니다. 락 없이 진행하면 N대가 같은 건을 동시에 처리하고, 외부 시스템에 같은 요청이 여러 번 나갑니다. UNIQUE는 행이 생길 때만 막지, 이미 있는 행을 둘이 같이 집는 것은 막지 못합니다. 앞 절들을 만든 이유가 그걸 막는 것이었으니 그런 폴백은 장애를 사고로 바꾸는 장치가 됩니다.
중복 처리되는 것보다는 처리가 늦어지는 쪽이 안전한 실패입니다.
서버가 다운되어 상태 행만 남을 때
다운된 서버의 락은 만료 시간이 지나 알아서 사라집니다. 남는 문제는 IN_PROGRESS인 채로 지워지지 않는 상태 행입니다. 후보 쿼리가 그 상태를 빼므로 이 요청은 누구에게도 다시 보이지 않습니다.
앞의 것은 같은 건이 두 곳에서 처리되는 것을 막는 이야기였고, 이건 한 건이 영원히 처리되지 않는 것을 막는 이야기입니다. 그래서 답이 다른 곳에 있습니다.
클렌징 스케줄러가 그 행을 되살립니다.
E. 클렌징 스케줄러: 지워지지 않고 남은 상태 레코드를 정리합니다
성공하면 행을 지우는 설계인데, 정상 경로로는 지워지지 않는 행이 남습니다. 그 행들을 정리하는 스케줄러가 따로 있습니다. 처리 루프와 달리 이 스케줄러에는 ShedLock을 걸어 워커 한 대에서만 돕니다. 전체를 훑어 일괄로 처리하는 일이라 N대가 동시에 돌면 서로의 결과가 헛돌게 됩니다.
정리 대상은 두 종류입니다.
- 처리 중이던 서버가 다운되어
IN_PROGRESS에서 멈춘 행. 앞 절에서 본 경우입니다. - 자동승인이 손을 댄 뒤 담당자가 직접 승인이나 반려를 해서, 요청은 이미 완료인데 남아 있는 행. 후보 쿼리가 요청 상태로 걸러내니 기능상 문제는 없지만 행이 쌓입니다.
첫 번째는 예상치 못하게 멈춘 것이므로 다시 처리되어야 합니다. 상태를 RETRY_WAITING으로 되돌리면 다음 폴링에서 재시도 대상으로 다시 잡힙니다. 되돌릴 때 요청에 실패 메모를 남깁니다. 조용히 되돌리면 담당자는 자동승인이 왜 늦었는지 알 수 없습니다.
두 번째는 담당자가 이미 처리한 요청이라 되살릴 것이 없습니다. 행을 지웁니다.
멈춘 것으로 판단하는 기준 시간은 한 건의 최대 처리 시간보다 넉넉해야 합니다. 짧게 잡으면 아직 살아서 처리 중인 건을 죽은 것으로 보고 되돌리게 되고, 앞에서 막으려던 중복이 클렌징 스케줄러 때문에 생깁니다.
재시도 한도에 도달한 행은 그대로 둡니다
재시도 횟수가 한도인 300번에 도달했다고 지우지는 않습니다. 후보 쿼리가 횟수 조건으로 걸러내고, 위 두 가지 어디에도 걸리지 않습니다. 그 횟수까지 실패했다면 자동으로 다시 시도해서 풀릴 문제가 아니라고 봤습니다. 담당자가 요청을 처리해 상태가 바뀌면 두 번째 대상이 되어 그때 정리됩니다.
F. 락을 하나도 못 잡은 턴은 그냥 넘기지 않습니다
첫 실행 시각을 흩어 두어도 N대가 같은 쿼리를 실행하는 순간은 옵니다. 그러면 모두 같은 상위 30건을 보고, 락은 요청 단위라 한 요청은 한 워커만 선점합니다. 앞 워커가 먼저 다 잡으면 나머지는 빈손으로 턴을 끝냅니다. 워커가 3대라도 일하는 것은 1대이고, 나머지 둘은 다음 턴까지 10초를 흘려보냅니다.
그래서 빈손으로 끝내는 대신, 같은 턴 안에서 다음 후보를 다시 조회합니다. 조회는 한 턴에 최대 세 번입니다.
흐름은 단순합니다.
라운드 = 0
do {
    후보 = 후보_조회()                // 요청 테이블과 상태 테이블을 한 번에 보는 그 조회
    if (후보 없음) return             // 할 일이 없으면 이 턴은 여기서 끝
    결과 = 후보를 건별로 병렬 처리     // 각 원소: 내가 이 건을 선점해서 처리했는가
    라운드 += 1
} while (결과에 성공이 하나도 없음 && 라운드 < 최대_라운드)
앞 워커가 선점한 건은 IN_PROGRESS가 되어 후보 쿼리에서 빠지므로 기대하는 재조회 결과는 그다음 새로운 후보입니다. 하지만 늘 그렇게 되는 건 아닙니다. 재조회는 락 시도가 전부 실패한 직후에 나가는데, 그 사이 앞 워커의 기록이 복제본에 반영될 시간은 라운드 하나 길이뿐입니다. 같은 후보를 다시 보는 경우가 드물지 않고, 그때는 라운드 상한까지만 돌고 아무 처리 없이 끝납니다. 재조회만 쓰기 DB로 보내면 확실해지지만, 후보 조회를 복제본에 맡겨 쓰기 DB를 지킨다는 선택과 맞바꾸는 일입니다.
상한을 둔 것은 계속 실패하면 처리는 못 하면서 조회만 반복하기 때문입니다. 포기해도 잃는 것은 없습니다. 다른 서버들이 다 가져갔다는 것은 그 건들이 이미 처리되고 있다는 뜻입니다.
반대로 일부라도 락을 잡은 턴은 재조회하지 않습니다. 두 경우는 턴 길이가 다르기 때문입니다.
락을 하나도 못 잡은 턴은 조회만 하고 끝나서 짧습니다. 한 번 더 조회해도 턴이 길어지지 않습니다. 반면 일부라도 잡은 턴은 그 건들을 다 처리하고서야 끝나므로 수 초가 걸립니다. 여기서 더 조회하면 턴은 더 길어집니다. fixedDelay는 턴이 끝난 시점부터 10초를 세니, 턴이 길어진 만큼 다음 턴이 늦게 시작합니다.
그래서 잡은 건만 처리하고 턴을 끝냅니다. 남은 물량은 늦어도 10초 뒤 다음 턴이 가져갑니다.
G. 처리 파이프라인: 프로세서마다 신규 데이터를 다시 읽습니다
락을 잡은 뒤 실행되는 승인 처리는 한 번이 아니라 세 프로세서의 연쇄 동작입니다. 업주 승인, 가게 승인, 광고 캠페인 승인 순서입니다. 광고계약 요청은 업주와 가게가 이미 있으므로 마지막 프로세서부터 시작합니다.
다음 그림의 왼쪽은 이 연쇄를 도는 루프이고, 오른쪽은 각 프로세서의 내부에서 하는 일입니다. 한 프로세서가 끝나면 루프의 처음으로 돌아갑니다.
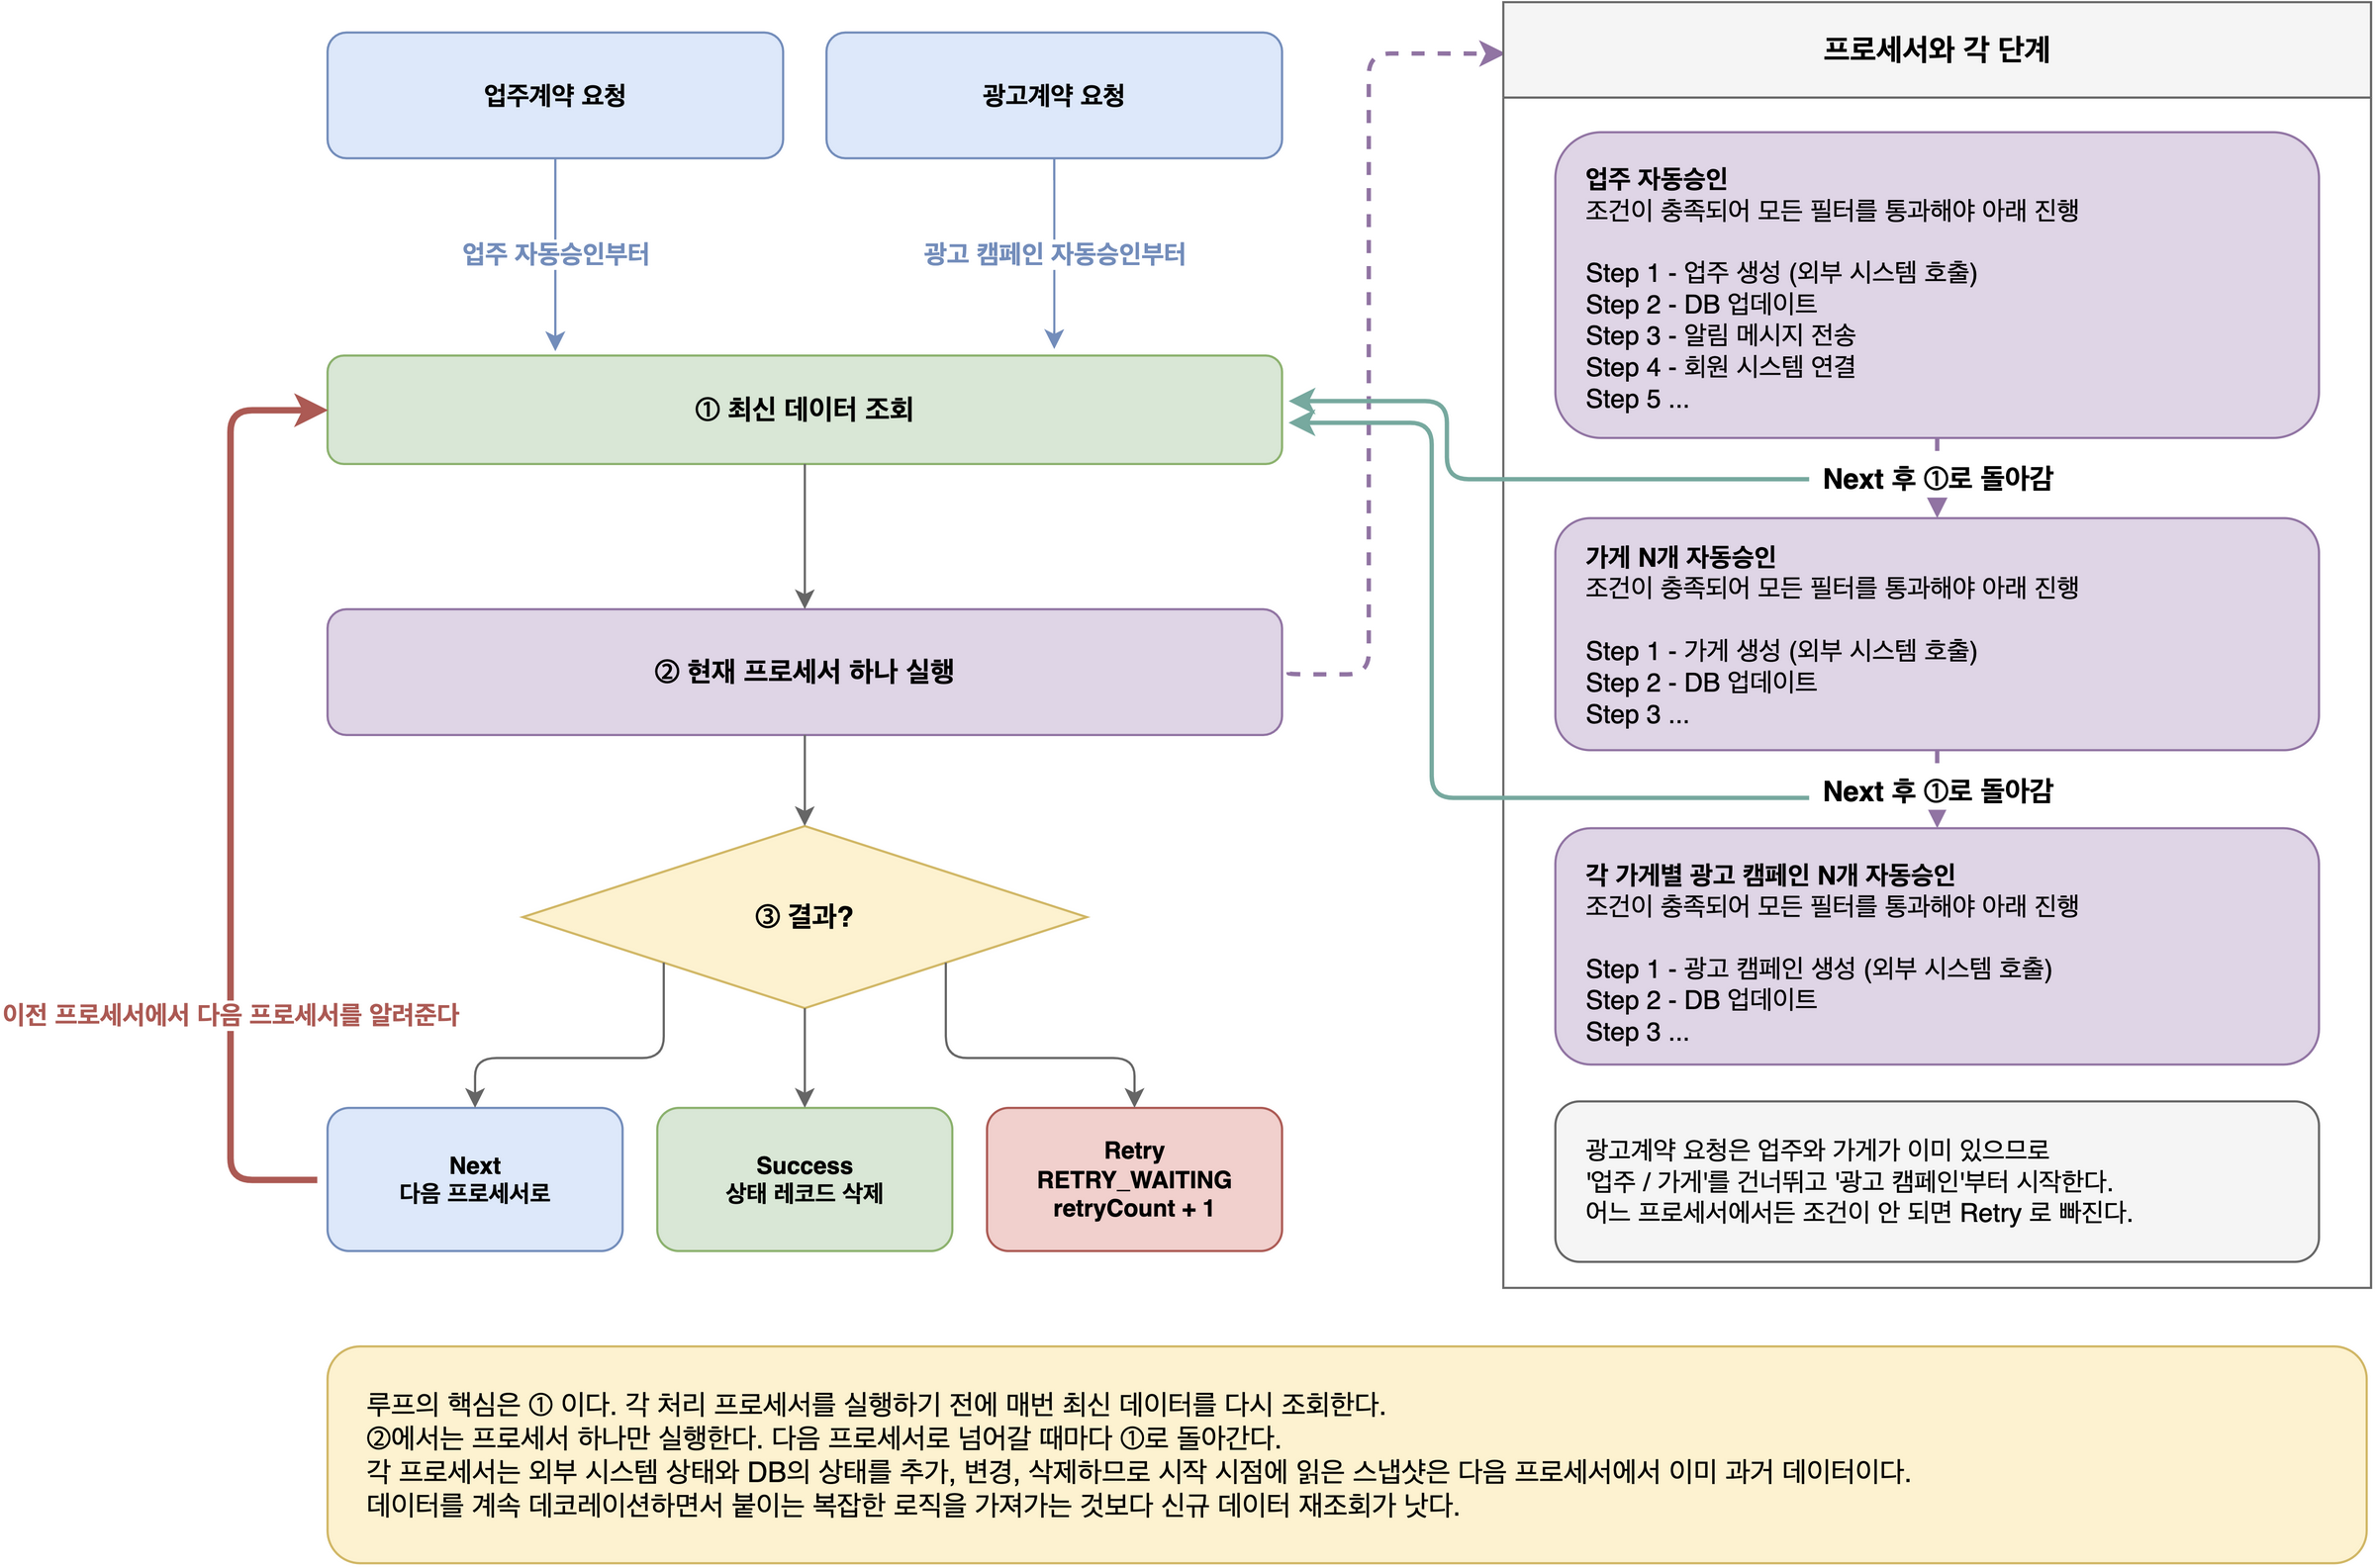
프로세서는 다음 프로세서로 넘길 때 Next를, 끝났을 때 Success나 Retry를 반환합니다. 프로세서 매니저는 그 결과로 루프를 돕니다.
작은 상태 머신입니다. ProcessType이 상태, Next가 전이, Success와 Retry가 종료이며, 순서를 아는 것은 매니저가 아니라 각 프로세서입니다. 매니저는 지목받은 프로세서를 찾아 실행할 뿐입니다.
프로세서를 넘어갈 때마다 요청 데이터를 처음부터 다시 조회합니다. 성능만 보면 낭비인데, 필요합니다.
- 각 프로세서가 외부 시스템 상태를 바꿉니다. 업주 승인이 업주를 만들고 가게 승인이 가게를 만드니, 시작 시점의 스냅샷은 다음 프로세서에서 이미 과거입니다.
- 전자계약서 진행 상태는 우리가 손대지 않아도 외부 시스템과 동기화되며 갱신됩니다.
- 그 사이 담당자가 같은 건을 수동으로 처리했을 수 있습니다. 재조회가 미완료 상태만 통과시키므로 처리는 그 자리에서 멈춥니다.
즉 각 프로세서는 실행 시점의 최신 정보를 기준으로 처리합니다. 이 재조회도 선점 직전 재확인처럼 쓰기 DB를 봅니다. 복제본을 보면 방금 갱신된 결과를 못 볼 수 있습니다.
재시도도 같습니다. 체인은 늘 그 요청의 첫 프로세서부터 다시 시작하고, 어디까지 갔는지를 따로 기록해 두지 않습니다. 대신 각 프로세서가 자기 일이 이미 끝났는지 확인하고, 끝났으면 건너뜁니다. 업주 번호가 이미 있으면 업주 프로세서는 그냥 다음으로 넘기고, 번호가 있는 가게는 이미 처리된 것으로 판단합니다.
다만 그 번호는 외부 시스템이 생성하고 우리는 그것을 받아 저장한 값입니다. 외부 시스템에 생성해 놓고 그 결과를 우리 DB에 쓰기 전에 서버가 죽으면, 다음 시도는 그 사실을 알 수 없어 또 만듭니다. 이 틈은 남아 있습니다. 외부에만 만들어진 데이터는 우리 쪽 관계가 끊긴 채 남으므로, 발견하면 따로 정리해야 합니다.
조건 판정은 프로세서마다 따로 있습니다
"승인해도 되는가"를 판정하는 조건은 한군데 모여 있지 않습니다. 프로세서마다 만드는 대상이 다르기 때문입니다. 그리고 그 조건들이 곧 자동승인의 조건입니다. 조건에 걸리면 그 프로세서에서 Retry로 빠지므로, 어느 프로세서까지 갔는지가 곧 어디까지 조건을 충족했는지를 뜻합니다.
조건이 많은 프로세서는 필터를 별도 컴포넌트로 분리했습니다. 각 필터가 대상 유형과 실행 순서를 스스로 선언하고, 프로세서는 지금 처리 중인 요청 유형에 해당하는 필터만 실행합니다. 새 정책은 필터 하나를 더하면 되고 처리 흐름은 그대로입니다.
결과
최소 3분을 대기하던 구간이 사라졌습니다. 개선 전에는 아무리 운이 좋아도 수집 스케줄러와 처리 스케줄러 사이의 3분을 기다려야 했고, 빠른 경우가 아예 없었습니다. 지금은 그 하한이 없고, 조건을 갖춘 요청은 다음 폴링에서 바로 처리됩니다.
서론에서 이 대기가 사람의 일로 넘어간다고 했습니다. 보통은 담당자가 목록에서 그 건을 발견하기 전에 자동승인이 이미 끝납니다.
전체 흐름
여기까지가 전부입니다. 앞에서 하나씩 본 것들을 개선 전 흐름과 나란히 비교한 그림입니다.
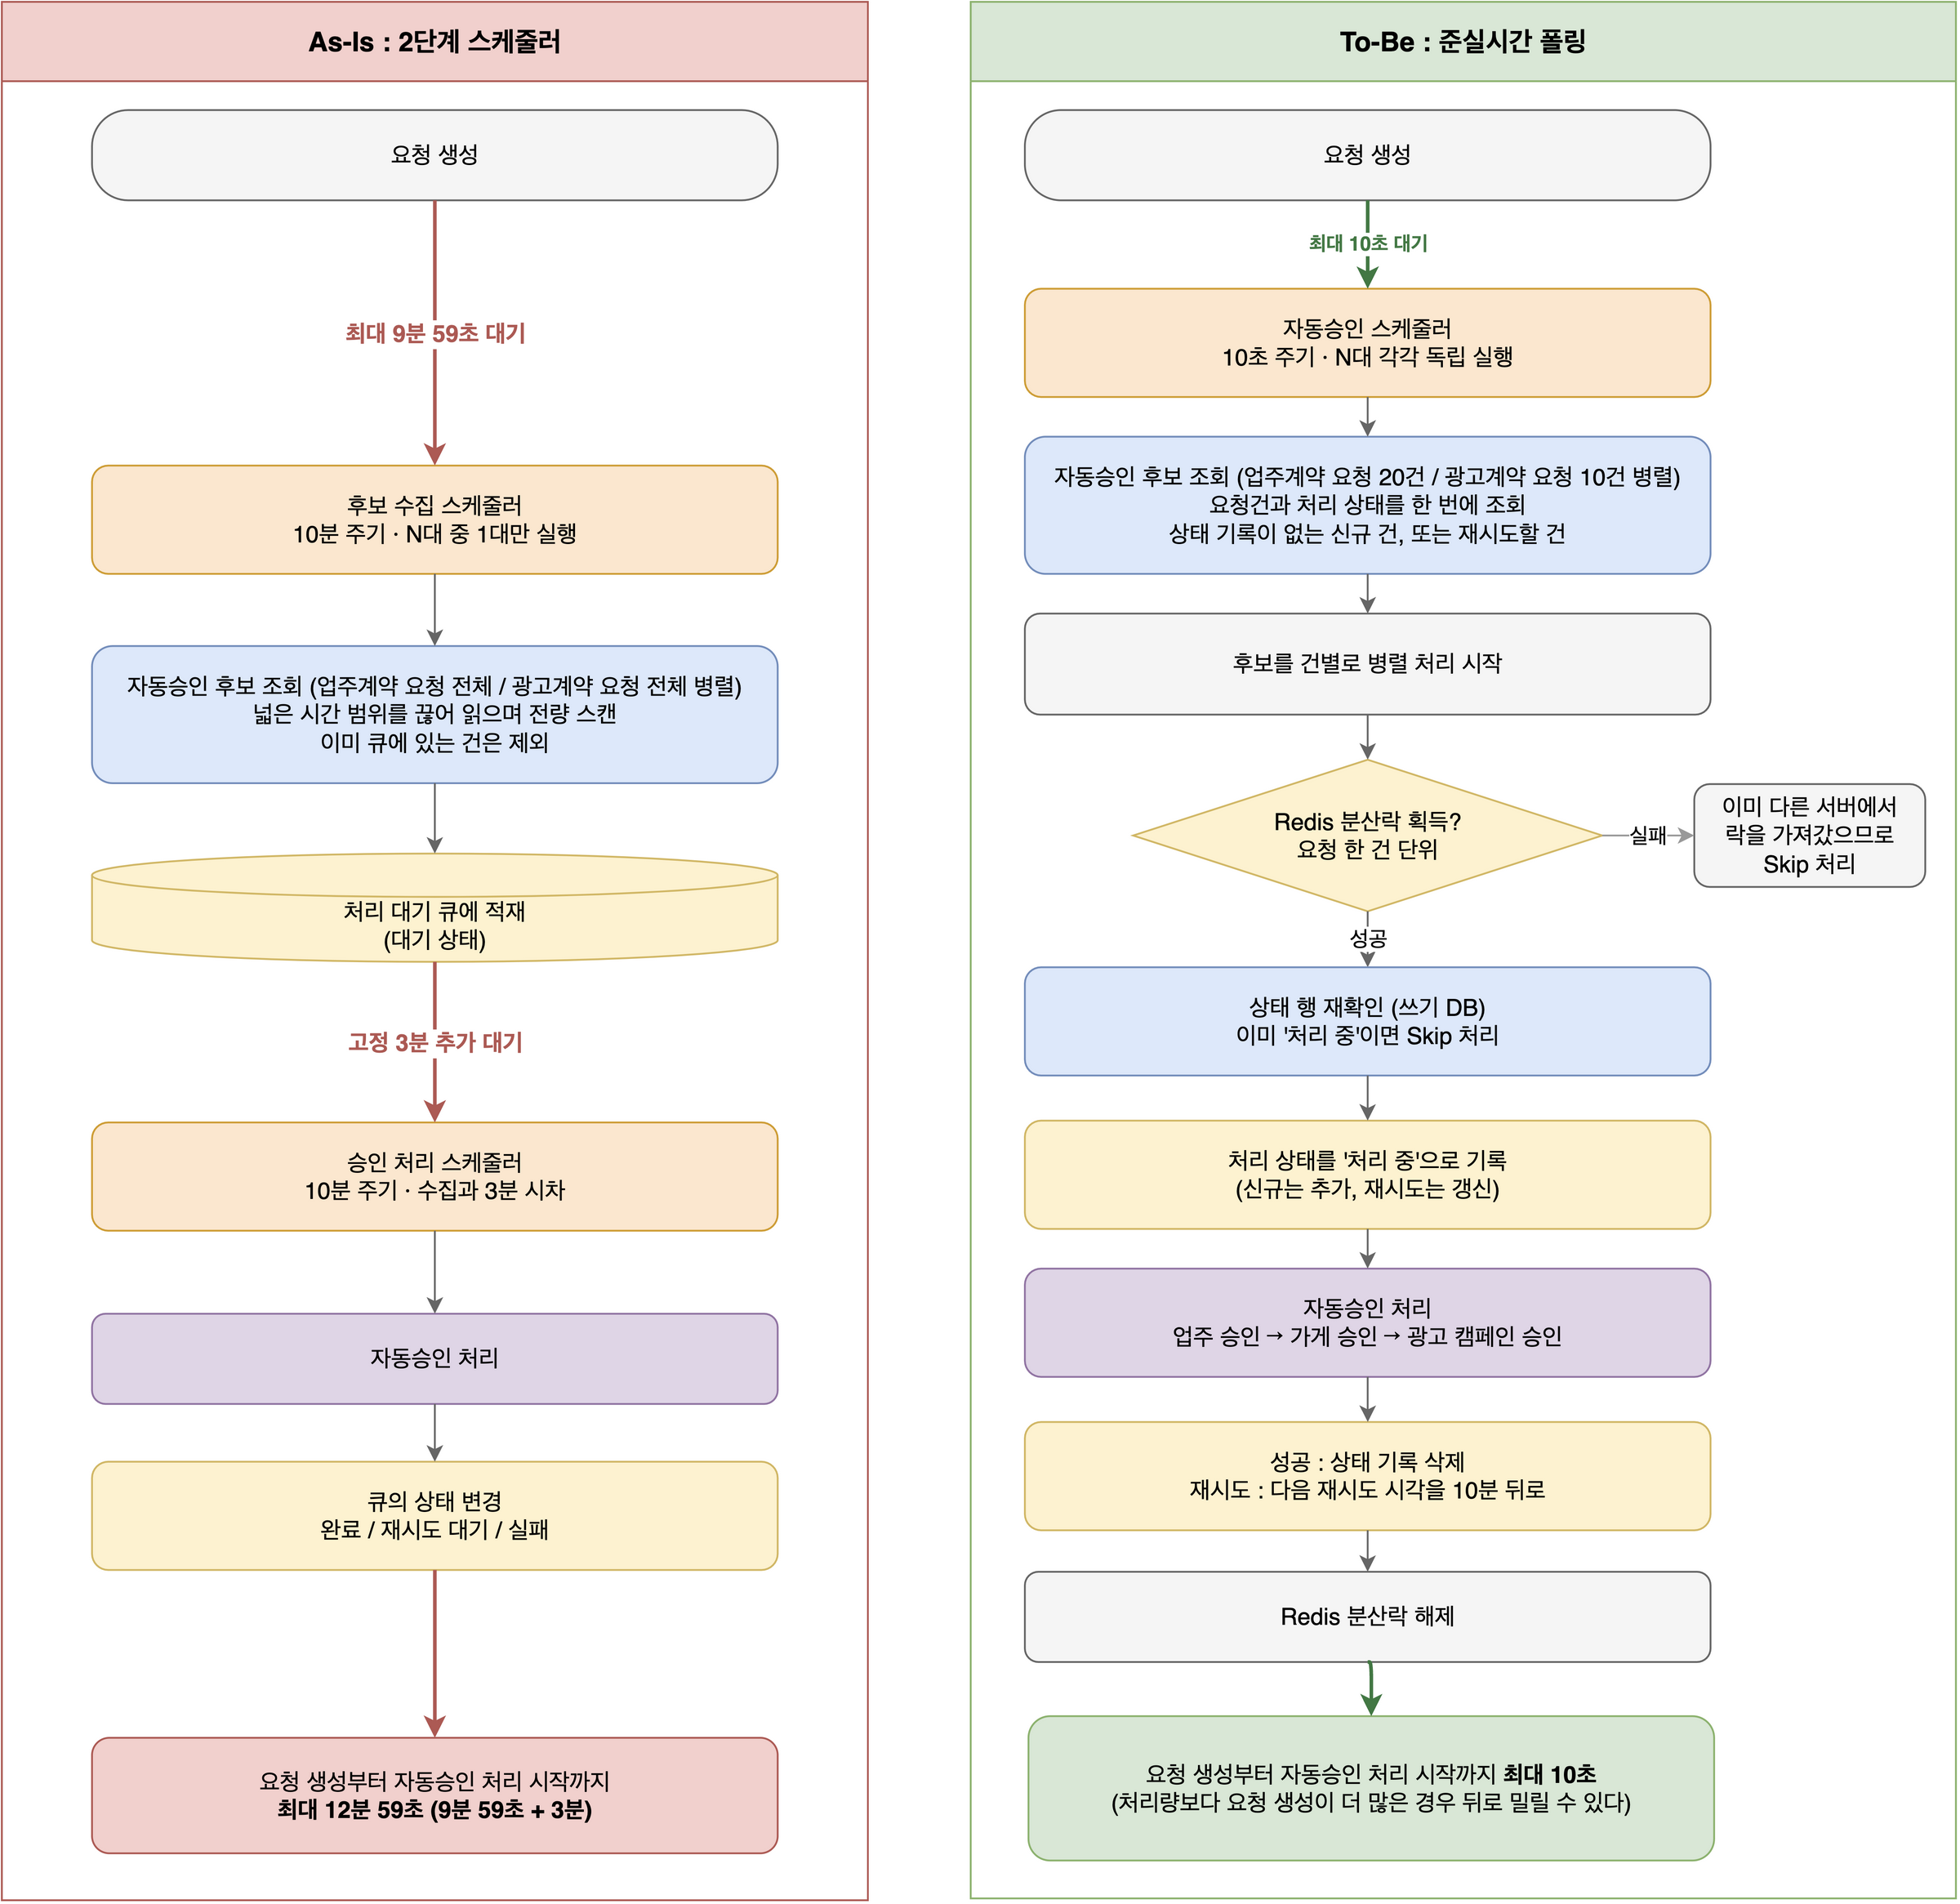
서론의 12분 59초는 이렇게 나옵니다. 후보 수집을 막 놓친 건은 다음 수집까지 9분 59초를 기다리고, 수집된 뒤에도 처리 스케줄러가 도는 3분을 더 기다립니다. 두 스케줄러를 다른 시각에 둔 대가가 그 3분입니다.
개선 후 흐름에는 적재 단계가 아예 없습니다. 큐를 걷어낸 결과입니다. 한 대만 돌던 것이 N대가 되고, 락 획득부터 상태 기록, 처리, 락 해제까지가 한 턴 안에서 이어집니다.
무엇을 대가로 냈고 무엇이 남았나
폴링 주기를 1/60로 줄인 대가는 우리 DB가 받았습니다
개선 전에는 워커 한 대가 10분에 한 번만 후보를 조회했습니다. 동시성 문제를 피하기 위해 ShedLock이 나머지 서버를 막고 있었습니다. 지금은 워커 N대가 각자 10초에 한 번씩 조회합니다. 한 번의 비용은 분명히 내려갔습니다. 개선 전 조회가 무엇을 했는지는 앞에서 봤습니다. 지금은 인덱스 조건과 LIMIT로 한 턴 처리 건수를 고정한 얇은 쿼리입니다. 그래도 총량은 늘었습니다.
여기에 LIMIT에 대한 오해를 하나 정리해 두겠습니다. 상태 레코드 조건은 LEFT JOIN 이후에 적용되므로, 후보 범위를 읽고 조인해 본 다음에야 통과 여부가 정해집니다. 통과한 건이 LIMIT에 못 미치면 범위를 끝까지 읽습니다. 즉 LIMIT는 최악을 막는 상한이지 평상시 비용을 줄이는 장치가 아닙니다. 밀린 물량이 없는 평상시에는 조기 종료가 아예 발동하지 않습니다. 한 번의 스캔 범위가 통과 건수에 따라 줄지 않으니, 실행 횟수가 늘어난 만큼 총 스캔량도 그대로 늘어납니다.
늘어난 쪽은 읽기 복제본입니다. 후보 조회가 복제본으로 가기 때문에 쓰기 DB는 이 증가를 거의 받지 않습니다. 쓰기 DB에 가는 것은 선점한 건의 상태 기록이고, 그 수는 폴링 주기가 아니라 실제 처리 건수가 정합니다. 결국 지연에서 줄인 것을 복제본 부하로 치렀습니다.
재시도 간격이 고정입니다
서론에서 꺼낸 문제 하나가 여기 그대로 남았습니다. 만들어질 때는 조건을 다 채우지 못했다가 나중에 갖춰지는 요청은, 조건이 갖춰진 뒤에도 다음 재시도 시각까지 기다립니다. 신규 건 발견은 10초가 됐지만 이쪽은 그대로입니다.
실패 원인이 무엇이든 10분 뒤에 다시 시도합니다. "서류 미제출"처럼 며칠이 걸릴 사유와 "외부 시스템 일시 오류"처럼 수 초면 풀릴 사유를 같은 간격으로 다룹니다. 지수 백오프나 사유별 차등 간격을 넣을 자리가 분명히 있습니다.
수동 승인은 다른 서비스에 있습니다
앞에서 쌓은 방어는 워커 N대가 서로 같은 건을 선점하는 것을 막습니다. 담당자의 수동 승인은 그 밖에 있습니다. 자동승인과 다른 서비스에서 수행되기 때문에 자동승인이 쓰는 락도 상태 테이블도 보지 않습니다. 지금 이 경합을 막으려면 서로 다른 서비스가 동일한 락을 잡아야 합니다.
그런데 락보다 먼저 있는 문제가 있습니다. 업주 승인, 가게 승인, 광고 캠페인 승인이 다른 서비스 두 곳에 각각 구현되어 있습니다. 정책 하나를 바꾸려면 두 서비스를 함께 고치고 함께 배포해야 합니다. 정책이 두 곳에 있는 채로 락만 공유하면 동시 실행만 막힐 뿐, 두 곳이 서로 다른 판정을 내리는 문제는 그대로입니다. 그래서 순서는 승인 로직 단일화가 먼저입니다.
한 곳으로 모이면 승인 단위 락을 두 경로가 함께 잡을 수 있습니다. 자동승인이 이미 하는 방식 그대로입니다. 락을 잡고 IN_PROGRESS를 기록한 다음에 외부 시스템을 부릅니다. 이 순서가 중요합니다. 승인은 외부 시스템의 데이터를 먼저 바꾸고 그 결과를 우리 DB에 쓰기 때문에, 락을 DB에 쓰는 시점에 잡으면 충돌을 알아차렸을 때 외부는 이미 바뀌어 있습니다. 락은 외부 호출 앞에 있어야 합니다.
마치며
돌아보면 이 작업에서 얻은 것은 "폴링 주기를 줄였다"가 아니었습니다.
-
폴링 주기와 재시도 주기는 다른 문제입니다.
하나의 값에 묶여 있던 두 관심사를 분리하지 않고 주기만 줄였다면, 우리 지연을 1/60로 줄이는 대가로 다른 시스템에 60배 부하를 보냈을 것입니다. 개선이 아니라 전가입니다. -
분산 환경에서 "정확히 한 번"은 추가 비용이 필요합니다.
서버 한 대가 10분에 한 번 처리하던 일을 N대 모두가 10초에 한 번 처리하게 만드는 순간, 같은 건에 두 대가 동시에 접근하는 상황은 예외가 아니라 일상이 됩니다. 주기를 줄이는 작업으로 시작했지만 실제로 시간을 쓴 곳은 이쪽이었습니다. -
구조가 파라미터보다 먼저입니다.
10초라는 숫자 자체는 중요하지 않았습니다. 재시도를 폴링에서 떼어내고 후보 조회를 한 단계로 줄이고 나니, 그 숫자는 넓은 구간 안 어떤 값이어도 상관없게 돼 있었습니다.
마지막으로 남는 것은 "배치라서 10분"이라는 전제를 아무도 다시 묻지 않았다는 사실입니다. 조건 판정은 수 초면 끝나는 일로, 10분이어야 할 이유는 없었습니다.
잘 동작하고 있어 문제가 없는 코드일수록 왜 그런 모양인지 묻기 어려워집니다. 그 질문을 다시 꺼내는 일이 이번 작업의 절반이었습니다.
